 JW的播客整理
从一场长谈开始,慢慢建立自己的知识地图。当前文章为格式示例,访谈信息待核实。
歌单待添加 · JW 将在这里分享喜欢的音乐。
音乐
暂未播放
0:000:00
陈天奇|访谈内容与知识整理
660 字
3 分钟
陈天奇|访谈内容与知识整理
- 1陈天奇|访谈内容与知识整理本文
主持人 · 何泰然
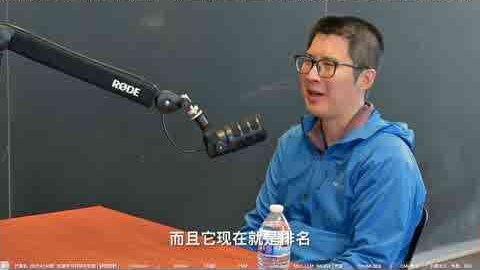
嘉宾 · 陈天奇
整理说明:正文根据 JW 提供的资料编排,不是逐字实录。原视频已核对到节目官方 B 站账号;下列日期为视频发布日期,不能等同于录制日期。正文的具体表述和数值仍待逐条核对。
访谈基本信息
| 项目 | 内容 |
|---|---|
| 访谈节目 | whynotTV |
| 被采访者 | 陈天奇 |
| B 站原视频 | 观看原访谈 ↗ |
| 视频发布账号 | WhynotTV |
| 视频发布日期 | 2025-09-12 |
| 访谈录制日期 | 未确认;以上视频发布日期不作为录制日期 |
| 整理来源 | JW 提供的人物与访谈整理资料 |
访谈内容整理
- 开源传奇的进化史:
- XGBoost 时代:在华盛顿大学期间将梯度提升树(GBDT)系统推到极致,成为 Kaggle 数据科学竞赛必备神枪。
- MXNet 时代:早于 PyTorch / TensorFlow 探路深度学习框架,主打极致内存优化与多卡并行。
- TVM 时代:开创深度学习编译器领域,打通“不同神经网络框架”到“不同芯片硬件”之间的自动化编译桥梁。
- MLC LLM 时代:在大模型时代推动“端侧大模型部署”,让几百亿参数的模型流畅运行在手机、电脑等端侧设备上。
- 长期主义与“敢于失败”:分享如何在学术教职、商业创业(OctoML)与开源社区治理三者间保持平衡,以及在AI浪潮迅速更迭中如何抵御短期浮躁、坚持高价值长线研发。
技术与商业知识
- XGBoost:陈天奇开发的开源梯度提升树(GBDT)高效实现库,因极高的计算速度与准确率在机器学习竞赛与工业界被广泛使用。
- TVM(深度学习编译器):一个开源的端到端深度学习编译栈,可将任意深度学习框架生成的模型自动优化并部署到异构硬件(CPU、GPU、NPU)上。
- MLC LLM(Machine Learning Compilation for LLM):陈天奇团队发起的开源项目,旨在利用深度学习编译技术实现大语言模型在各种设备(包括手机、笔记本、嵌入式硬件)上的高效端侧部署。
- 端侧推理(On-Device Inference):无需依赖云端服务器算力,直接在用户本地设备(如智能手机、PC、汽车)上运行 AI 大模型推理的技术。
JW 的个人心得
待 JW 观看原访谈后补充。欢迎在下方评论区分享你的理解、补充与不同看法。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
相关文章智能推荐
1
胡渊鸣|访谈内容与知识整理
whynotTVTaichi 与 Meshy 相关创业者;关注图形学、开源与 3D 生成。
2
姚顺宇|访谈内容与知识整理
张小珺的商业访谈资料围绕模型训练、工程实践与 AI 团队展开;人物履历和同音姓名仍待核对。
3
杨植麟|访谈内容与知识整理
张小珺的商业访谈月之暗面与 Kimi 创始人;关注大模型创业、Agent 与模型效率。
4
朱江明|访谈内容与知识整理
罗永浩的十字路口零跑汽车创始人;关注工程师创业、自研和制造效率。
5
谢赛宁|访谈内容与知识整理
张小珺的商业访谈计算机视觉研究者;资料关注视觉表征、生成模型与世界模型。
随机文章随机推荐
评论区
歌单待添加 · JW 将在这里分享喜欢的音乐。
音乐
暂未播放
0:000:00
从一场长谈开始,慢慢建立自己的知识地图。当前文章为格式示例,访谈信息待核实。
文章
9
分类
4
标签
7
总字数
10,685
运行时长
0 天
最后活动
0 天前